- By BitSeed
- Công nghệ giọng nói
- 18 Sep
Cách thức hoạt động của công nghệ nhận dạng giọng nói trên thiết bị biên
Việc triển khai công nghệ nhận dạng giọng nói trên thiết bị biên, về bản chất, là một quá trình tái cấu trúc sâu sắc của kiến trúc tính toán. Nhận dạng giọng nói đám mây truyền thống phụ thuộc vào sức mạnh tính toán mạnh mẽ của máy chủ và khả năng xử lý dữ liệu khổng lồ, trong khi triển khai biên đòi hỏi phải thực hiện các chức năng tương tự trên phần cứng cấp vi điều khiển. Sự chuyển đổi này đã tạo ra các lộ trình công nghệ hoàn toàn mới, trong đó nén mô hình trở thành điểm đột phá关键.
Các công nghệ nén mô hình chính hiện nay bao gồm ba phương pháp cốt lõi: lượng hóa, cắt tỉa và tinh chế kiến thức. Công nghệ lượng hóa có thể giảm dung lượng mô hình 75% bằng cách giảm tham số mô hình từ số thực 32 bit xuống số nguyên 8 bit, đồng thời duy trì độ chính xác trên 98%. Trong ứng dụng thực tế, dung lượng mô hình nhận dạng giọng nói sau xử lý lượng hóa có thể được nén xuống 1/16 kích thước ban đầu, khiến thiết bị thông minh được trang bị động cơ suy luận nhẹ MXNet có thể đạt được khả năng phân tích đặc trưng giọng nói 120 khung hình mỗi giây. Công nghệ cắt tỉa则通过移除神经元或 kết nối dư thừa, giảm độ phức tạp tính toán trong khi vẫn duy trì hiệu suất mô hình, các案例典 hình cho thấy có thể tăng tốc độ suy luận mô hình lên 40% và giảm占用 bộ nhớ xuống 60%.
Là phương án tối ưu hóa端到端, tinh chế kiến thức đã thành công nén mô hình giọng nói cấp 200MB xuống dưới 15MB bằng cách truyền biểu diễn đặc trưng từ mô hình lớn sang mô hình nhỏ, đồng thời duy trì 99,3% hiệu suất mô hình ban đầu. Việc ứng dụng phối hợp các công nghệ này使得 mô hình nhận dạng giọng nói có thể实现 độ trễ suy luận dưới 23 mili giây trên chip kiến trúc ARM,较基準 ngành cách đây ba năm提升 gần 4 lần.
Sáng tạo công nghệ của khung tính toán biên
Việc tối ưu hóa khung tính toán biên là cơ sở hạ tầng关键 để triển khai thành công công nghệ nhận dạng giọng nói. Kiến trúc tính toán biên hiện đại采用协同 sáng tạo giữa nút phân tán và khả năng xử lý dữ liệu cục bộ, phá vỡ giới hạn độ trễ phản hồi trong mô hình đám mây truyền thống. Động cơ suy luận nhẹ trên thiết bị có thể rút ngắn thời gian trích xuất đặc trưng giọng nói xuống dưới 20 mili giây,较方案 truyền tải đám mây降低 83% độ trễ tương tác.
Điều đáng chú ý là, việc giới thiệu khung học tập liên bang使 các nút phân tán có thể hoàn thành lặp lại mô hình thông qua truyền tải mã hóa gradient mà không cần chia sẻ dữ liệu giọng nói gốc, vừa đảm bảo an toàn riêng tư又维持 mức độ提升准确率 nhận dạng hàng tháng 13,6%. Kiến trúc công nghệ này đã thể hiện giá trị巨大 trong các场景 cao nhạy cảm như xác thực vân tay âm thanh tài chính,使 tốc độ phản hồi端到端突破 ngưỡng临界 200 mili giây, đạt tiêu chuẩn trải nghiệm tương tác đối thoại tự nhiên của con người.
Thuật toán trích xuất đặc trưng采用 cơ chế cửa sổ trượt降低 năng lượng tiêu thụ xử lý tín hiệu giọng nói 42%, kết hợp với công nghệ tối ưu hóa học tập tự thích ứng, hệ thống có thể tự động切換 phiên bản mô hình giảm tiếng ồn theo mức độ tiếng ồn môi trường. Trong lĩnh vực kiểm tra chất lượng công nghiệp, kiến trúc này đã hỗ trợ xử lý song song 200 kênh giọng nói, kết hợp với động cơ thực thi bất đồng bộ,将 độ trễ suy luận端到端控制 ổn định trong ngưỡng 120 mili giây.
Sự tiến hóa chuyên môn của nền tảng phần cứng
Công nghệ nhận dạng giọng nói có thể hoạt động thành công trên thiết bị biên không thể thiếu sự hỗ trợ của nền tảng phần cứng chuyên môn. Thiết kế kiến trúc chip AI biên主流 hiện nay呈现 đặc trưng đa dạng dị cấu, DSP âm thanh, NPU âm thanh trở thành thành phần không thể thiếu.以 chip R329 do Allwinner Technology liên hợp Arm Trung Quốc推出为例, tích hợp tổng cộng 5 hạt tính toán bao gồm AIPU, DSP, CPU, HIFI4 kép nhân, các tối ưu hóa về độ chính xác và tốc độ di chuyển thuật toán使得 yêu cầu sức mạnh tính toán học sâu của khách hàng đối với chip出现 tăng trưởng指數级.
Chip AI giọng nói chuyên môn thường具备 đặc trưng vừa có sức mạnh tính toán lớn又 có công suất thấp,以实现 thiết bị có pin có thể thức dậy từ trạng thái đợi, cần ít nhất được trang bị SRAM dung lượng không nhỏ hơn 2MB, băng thông bộ nhớ trong trạng thái công suất thấp cần ít nhất lớn hơn 600MB/S. Trong một phương án công nghệ运行 xử lý tín hiệu giọng nói và多达 50 lệnh từ ngoại tuyến trên một DSP, có thể đạt được tỷ lệ nhận dạng trên 90% trong điều kiện có tiếng ồn,突破 công nghệ này使得 các thiết bị như kính AR có thể实现操作 toàn giọng nói không cần kết nối mạng trong môi trường công nghiệp khắc nghiệt.
Phát triển công nghệ TinyML为 nhận dạng giọng nói cấp vi điều khiển提供 khả năng mới. Số lượng thiết bị TinyML预计将 tăng từ 15 triệu năm 2020 lên 2,5 tỷ năm 2030, công nghệ này tối ưu hóa thuật toán thông qua các phương pháp như lượng hóa, cắt tỉa, nén mô hình等,使 mô hình học máy có thể运行 hiệu quả trên các thiết bị hạn chế tài nguyên như vi điều khiển, công suất运行 thường ở cấp mili vât, thích hợp cho các thiết bị được cấp nguồn bởi pin.
Sự thâm nhập sâu của场景 ứng dụng
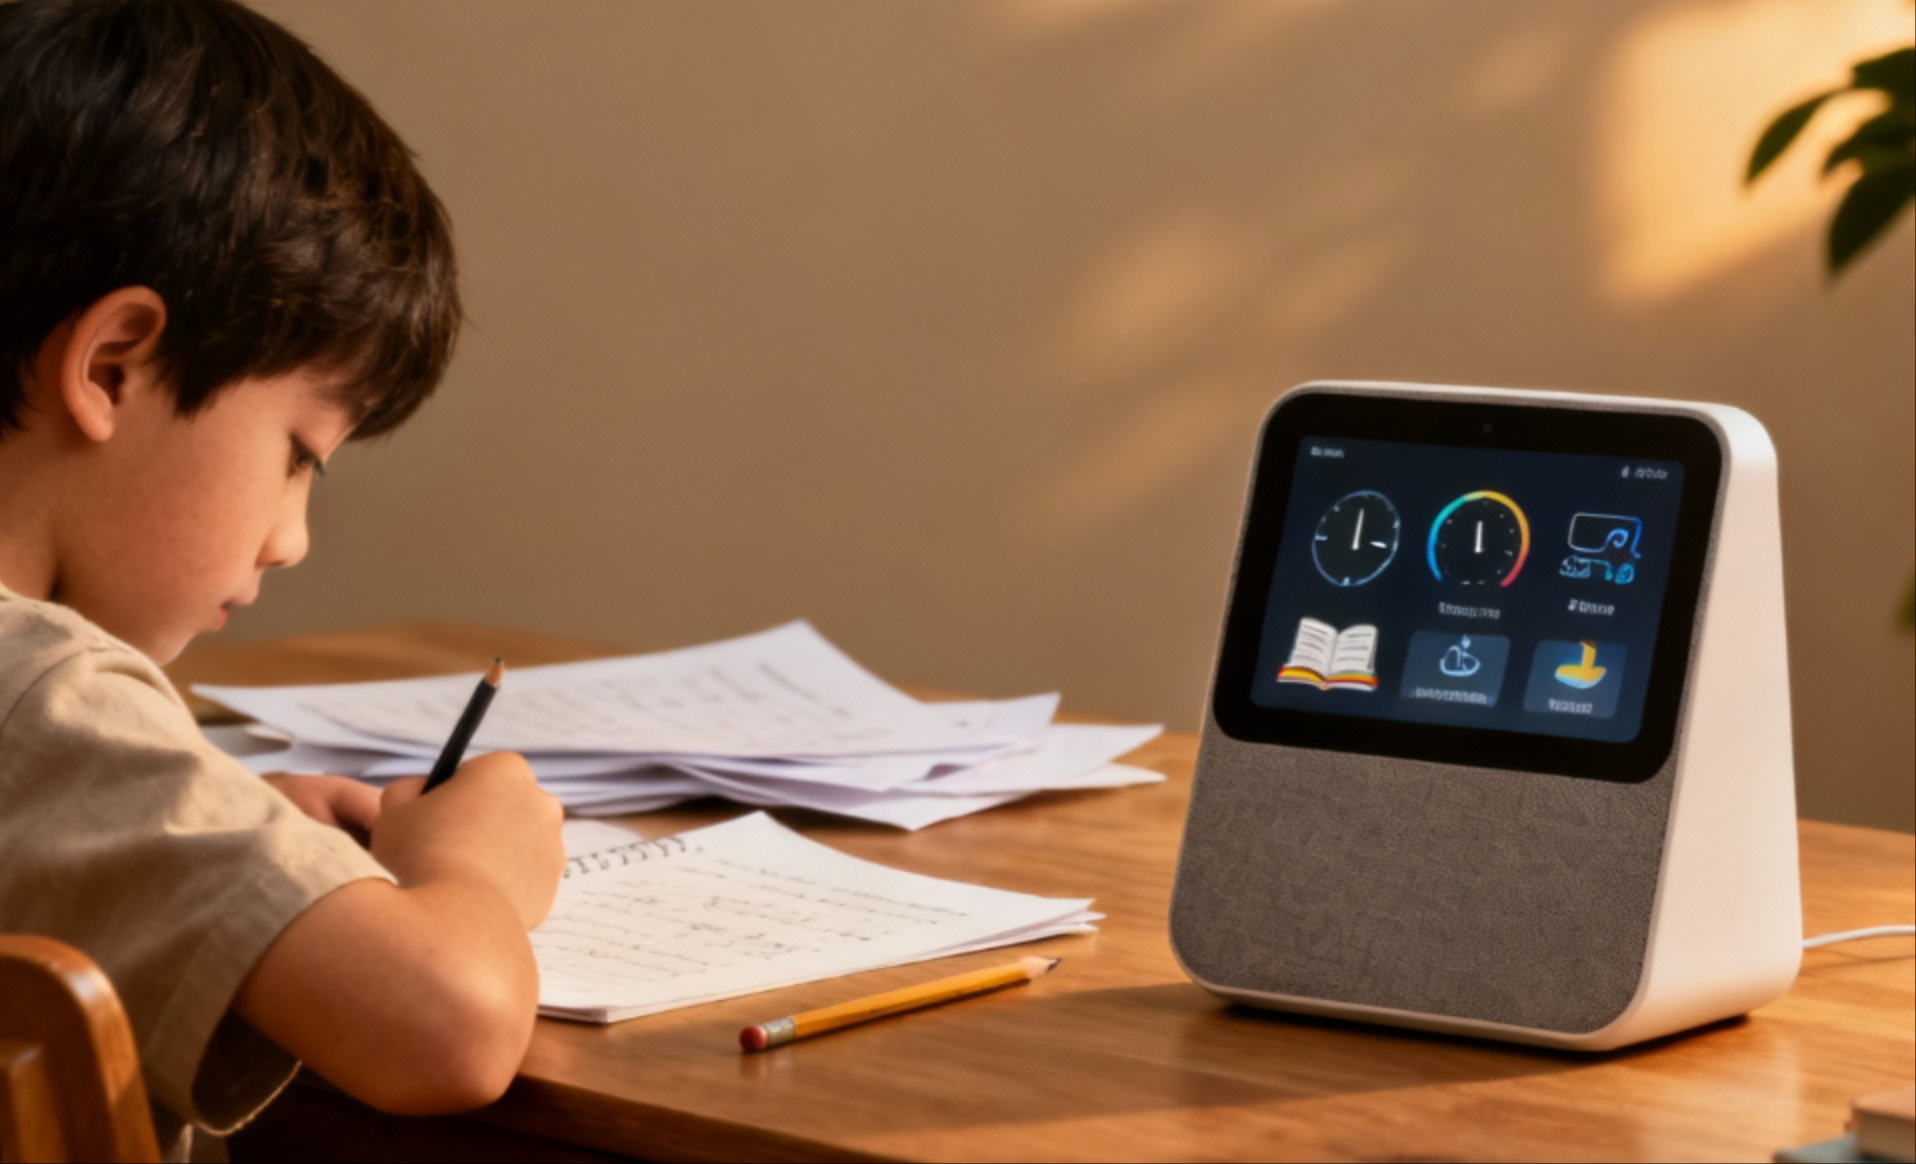
Ứng dụng của công nghệ nhận dạng giọng nói trên thiết bị biên正在向更多 lĩnh vực dọc thâm nhập sâu hơn. Trong场景 phòng khách khách sạn, thiết bị端 tương tác giọng nói thông minh作为 điểm tiếp xúc gần nhất với khách,提供 trải nghiệm dịch vụ phản hồi tức thì thông qua sức mạnh tính toán biên. Quy mô thị trường khách sạn thông minh toàn cầu năm 2024 đạt 11,29 tỷ USD,预计 sẽ tăng至 52,82 tỷ USD năm 2029, tăng trưởng nhanh chóng này为 nâng cấp thông minh phòng khách提供 không gian rộng rãi!
Loa thông minh作为载体重要 của tương tác giọng nói, mặc dù呈现態勢 điều chỉnh trên thị trường tiêu dùng,但展现 động lực tăng trưởng mới trong lĩnh vực ứng dụng thương mại. Trong nửa đầu năm 2024, doanh số thị trường loa thông minh Trung Quốc là 8,055 triệu chiếc, trong đó loa thông minh không màn hình正在向 Trung cao cấp tiến hóa, tỷ lệ thị phần của sản phẩm chất lượng cao具备音质 cao, ngoại hình đẹp开始 tăng trưởng. Sản phẩm mới loa thông minh搭載 mô hình lớn AI tự nghiên cứu có doanh số hàng tháng gần 10.000 chiếc,显示出 tác động của nâng cấp công nghệ đối với thị trường.
Trong lĩnh vực công nghiệp, triển khai biên của công nghệ nhận dạng giọng nói为 bảo trì dự đoán提供 giải pháp mới. Thông qua chiến lược cắt tỉa thưa phân cấp,可将 dung lượng mô hình ResNet-50 nén 76%, đồng thời duy trì độ chính xác nhận dạng ban đầu 98,3%,实现 trích xuất đặc trưng tín hiệu rung động hiệu quả. Dữ liệu đo thực tế của một doanh nghiệp gia dụng thông minh显示, sau khi kết hợp khung đào tạo phân tán của học tập liên bang, tỷ lệ lỗi nhận dạng từ kích hoạt có giọng địa phương下降 hơn 42%.
Thách thức công nghệ và triển vọng phát triển
Mặc dù ứng dụng của công nghệ nhận dạng giọng nói trên thiết bị biên đã đạt được tiến bộ đáng kể,但 vẫn面临 nhiều thách thức công nghệ. Cân bằng giữa độ chính xác và hiệu suất始终是難題核心,如何在 quá trình nén cực限同时 duy trì hiệu suất mô hình đủ mạnh需要創新 công nghệ持續. Vấn đề tương thích phần cứng同样突出, sự khác biệt lớn trong hỗ trợ tính toán thưa và độ rộng bit thấp của các chip biên khác nhau đòi hỏi nhà phát triển具备 khả năng tối ưu hóa跨平台.
Khả năng tổng quát hóa mô hình不足是另一个 thách thức关键, vấn đề độ chính xác下降 15-20%跨场景较为常見 trong triển khai thực tế. Khả năng thích ứng môi trường động態 kém cũng制约 ứng dụng quy mô lớn của công nghệ, tình trạng tỷ lệ thất bại suy luận do rung lắc mạng vượt quá 5%需要通过建立 cơ chế bù đắp động態来解决. Ngoài ra, sự缺失 của hệ thống bảo vệ an toàn使得 tỷ lệ phát hiện thay đổi mô hình thấp hơn 70%, điều này构成隐患重大 trong các场景 ứng dụng có yêu cầu an toàn cao.
Looking ahead, phát triển của công nghệ nhận dạng giọng nói trên thiết bị biên sẽ呈现出几个 xu hướng quan trọng. Đầu tiên là sự成熟进一步 của ngăn xếp công nghệ, sự phát triển phối hợp của nén mô hình, tăng tốc phần cứng và tối ưu hóa khung sẽ使 tốc độ suy luận端 biên提升 2-5 lần, năng lượng tiêu thụ降低 60-80%. Thứ hai là mở rộng持续 của场景 ứng dụng, từ gia dụng thông minh đến tự động hóa công nghiệp, từ giám sát y tế đến giáo dục đào tạo, tương tác giọng nói将成为 phương thức tiêu chuẩn của tương tác người-máy. Cuối cùng là sự完善 của hệ sinh thái, các giải pháp tích hợp phần cứng-phần mềm sẽ降低 ngưỡng công nghệ,推动 ứng dụng quy mô của công nghệ nhận dạng giọng nói trên thiết bị biên.

 28 Oct, 2025