- By BitSeed
- 음성 기술
- 18 Sep
음성 인식 기술이 엣지 장치에서 어떻게 작동합니까?
엣지 장치에서 음성 인식 기술을 구현하는 것은 본질적으로 컴퓨팅 아키텍처의 심층 재구성입니다. 전통적인 클라우드 음성 인식은 강력한 서버 컴퓨팅 능력과 대량 데이터 처리 능력에 의존하는 반면, 엣지 배포는 마이크로컨트롤러 수준의 하드웨어에서 동일한 기능을 구현해야 합니다. 이러한 변화는 새로운 기술 경로를 낳았으며, 그 중 모델 압축이 핵심 돌파구가 되었습니다.
현재 주류 모델 압축 기술에는 양자화, 가지치기 및 지식 증류의 세 가지 핵심 방법이 포함됩니다. 양자화 기술은 모델 매개변수를 32비트 부동 소수점에서 8비트 정수로 줄임으로써 모델 크기를 75% 줄일 수 있으며, 동시에 98% 이상의 정확도를 유지합니다. 실제 응용에서 양자화 처리된 음성 인식 모델의 크기는 원래 규모의 1/16으로 압축될 수 있어 MXNet 경량화 추론 엔진을 탑재한 지능형 하드웨어가 초당 120프레임의 음성 특징 해석 능력을 구현할 수 있습니다. 가지치기 기술은 불필요한 뉴런이나 연결을 제거함으로써 모델 성능을 유지하면서 계산 복잡성을 낮추며, 전형적인 사례에 따르면 모델 추론 속도를 40% 향상시키고 메모리 사용량을 60% 줄일 수 있습니다.
엔드투엔드 최적화方案으로서의 지식 증류는 대형 모델에서 소형 모델로 특징 표현을 전달함으로써 200MB급 음성 모델을 15MB 이내로 성공적으로 압축하였으며, 동시에 원래 모델 성능의 99.3%를 유지하였습니다. 이러한 기술의 협동 응용으로 음성 인식 모델은 ARM 아키텍처 칩에서 추론 지연 시간을 23밀리초 이내로 줄일 수 있었으며, 3년 전 업계 기준에 비해 거의 4배 향상되었습니다.
엣지 컴퓨팅 프레임워크의 기술 혁신
엣지 컴퓨팅 프레임워크의 최적화는 음성 인식 기술의 성공적인 배포를 위한 핵심 기반 시설입니다. 현대 엣지 컴퓨팅 아키텍처는 분산 노드와 로컬 데이터 처리 능력의 협동 혁신을 채택하여 전통적인 클라우드 컴퓨팅 모델의 응답 지연 병목 현상을 돌파하였습니다. 장치 단의 경량화 추론 엔진을 기반으로 음성 특징 추출 시간을 20밀리초 이내로 단축할 수 있어 클라우드 전송方案에 비해 상호 작용 지연을 83% 감소시킵니다.
주목할 만한 것은 연방 학습 프레임워크의 도입으로 분산 노드가 원본 음성 데이터를 공유하지 않고도 그래디언트 암호화 전송을 통해 모델 반복을 완료할 수 있어 프라이버시 보안을 보장하면서도 월간 인식 정확도를 13.6% 향상시킬 수 있습니다. 이러한 기술 아키텍처는 금융 음성纹 인증과 같은 고민감한 시나리오에서巨大한 가치를 나타내어 엔드투엔드 응답 속도가 200밀리초 임계값을 돌파하여 인간의 자연 대화와 같은 상호 작용 경험 표준에 도달하였습니다.
슬라이딩 윈도우 메커니즘을采用하는 특징 추출 알고리즘은 음성 신호 처리 에너지를 42% 감소시키며, 적응형 학습 최적화 기술과 함께 시스템은 환경 잡음 수준에 따라 자동으로 잡음 제거 모델 버전을 전환할 수 있습니다. 산업 검사 분야에서 이러한 아키텍처는 200채널 음성 채널의 병렬 처리를 지원하며, 비동기 실행 엔진과 함께 엔드투엔드 추론 지연을 120밀리초 임계값 내로 안정적으로 제어합니다.
하드웨어 플랫폼의 전문화 발전
엣지 장치에서 음성 인식 기술이 성공적으로 작동하려면 전문화된 하드웨어 플랫폼의 지원이 필수적입니다. 현재 주류 엣지 AI 칩 아키텍처 설계는多重 이종 특징을 나타내며, 오디오 DSP, 오디오 NPU가不可或缺한 구성 요소가 되었습니다. 전志科技(Allwinner Technology)와 Arm 중국이 공동으로 출시한 R329 칩을 예로 들면, AIPU, DSP, CPU, 듀얼 코어 HIFI4를 포함한 총 5개의 계산 코어를 통합하였으며, 정확도와 알고리즘 포팅 속도의 최적화로 인해 고객의 칩에 대한 딥 러닝 컴퓨팅 능력 요구가 지수적으로 향상되었습니다.
전문화된 음성 AI 칩은 일반적으로 높은 컴퓨팅 능력과 낮은 전력 소비를兼具하는 특징을 가지고 있어 배터리 장착 장치의 대기 상태에서의 활성화를 구현할 수 있으며, 적어도 2MB 이상의 용량의 SRAM을配备해야 하며, 저전력 상태에서의 메모리 대역폭은 적어도 600MB/S 이상이어야 합니다. 하나의 DSP에서 음성 신호 처리와 최대 50개의 오프라인 명령어를运行하는 기술方案에서 잡음 환경에서 90% 이상의 인식률을 달성할 수 있으며, 이러한 기술 돌파로 AR 안경과 같은 장치가 열악한 산업 환경에서 인터넷 연결 없이 전체 음성操作을 구현할 수 있게 되었습니다.
TinyML 기술의 발전은 마이크로컨트롤러 수준의 음성 인식에 새로운 가능성을提供하였습니다. TinyML 장치 출하량은 2020년 1500만 대에서 2030년에는 25억 대로 급증할 것으로 예상되며, 이 기술은 양자화, 가지치기, 모델 압축 등의 방법으로 알고리즘을 최적화하여 머신 러닝 모델이 마이크로컨트롤러와 같은 자원 제한 장치에서 효율적으로运行할 수 있도록 하며,运行 전력 소비는 일반적으로 밀리와트 수준으로 배터리 공급 장치에 적합합니다.
응용 시나리오의 심층 침투
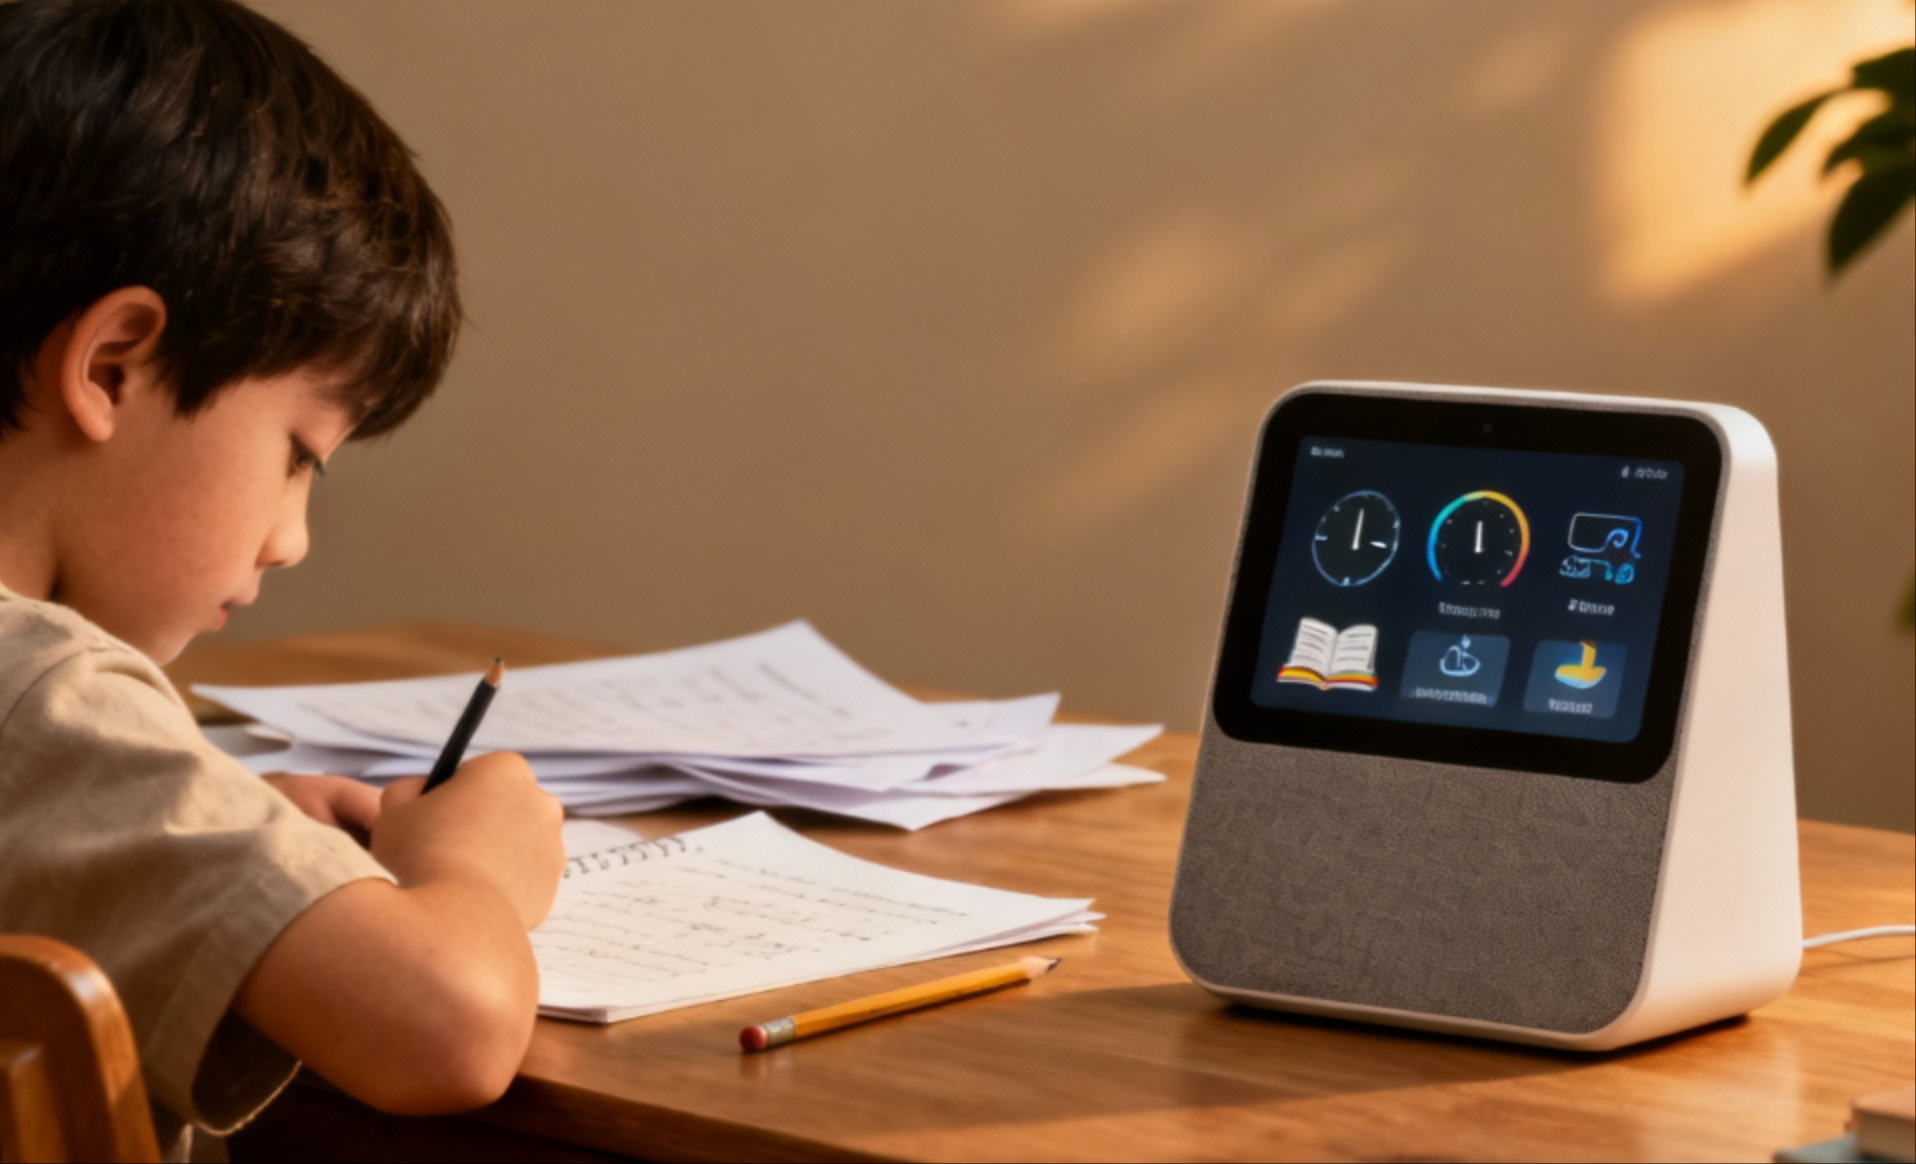
엣지 장치에서의 음성 인식 기술 응용은 더 많은 수직 분야로 심층 침투하고 있습니다. 호텔 객실 시나리오에서 지능형 음성 상호 작용 단말기는 투숙객에게 가장 가까운 접점으로서 엣지 컴퓨팅 능력을 통해 즉시 응답하는 서비스 경험을提供합니다. 2024년 전 세계 지능형 호텔 시장 규모는 112.9억 달러에 달하며, 2029년에는 528.2억 달러로 증가할 것으로 예상되며, 이러한 빠른 성장은 객실 지능화 업그레이드를 위한广阔한 공간을提供하고 있습니다!
지능형 스피커는 음성 상호 작용의重要한载体로서 소비 시장에서는调整态势를呈现하고 있지만 상업 응용 분야에서는 새로운 성장 동력을展现하고 있습니다. 2024년 상반기 중국 지능형 스피커 시장 판매량은 805.5만 대였으며, 그 중 무화면 지능형 스피커는 중고급화로 발전하고 있으며, 고음질, 고품질의 제품 시장 점유율이增长하기 시작했습니다. 자체 개발한 AI 대형 모델을 탑재한 지능형 스피커 신제품의 월간 판매량은 1만 대에 근접하며, 기술 업그레이드가 시장에 미치는 촉진作用을显示하고 있습니다.
산업 분야에서 음성 인식 기술의 엣지화 배포는 예측 유지 보수를 위한 새로운解决方案을提供하였습니다. 계층화된 희소 가지치기 전략을 통해 ResNet-50 모델 크기를 76% 압축할 수 있으며, 동시에 원래 인식 정확도의 98.3%를 유지하여 진동 신호 특징의 효율적인 추출을 구현합니다.某 스마트 홈 기업의 실측 데이터에 따르면 연방 학습을 결합한 분산 학습 프레임워크를采用한 후 지역 억양이 있는唤醒어 인식 오류율이 42% 이상下降하였습니다.
기술 과제와 발전 전망
비록 엣지 장치에서의 음성 인식 기술 응용이显著한 진전을 이루었지만 여전히 많은 기술 과제에 직면해 있습니다. 정확도와 효율성의 균형은始终核心 난제이며, 극도로 압축하는 동시에 충분한 모델 성능을 유지하는 방법은持续的技术创新이 필요합니다. 하드웨어 호환성 문제도同样突出하며,不同 엣지 칩의 희소 계산과 저비트 폭 지원에 큰差异가 있어 개발자는 크로스 플랫폼 최적화 능력을具备해야 합니다.
모델 일반화 능력 부족은 또 다른关键 과제이며,跨场景 정확도下降 15-20%의 문제는实际 배포中较为常见합니다. 동적 환경 적응성이差也技术의大规模应用을制约하며,网络抖动으로 인해 추론 실패율이 5%를超過하는情况에는动态补偿机制을建立하여解决해야 합니다.此外,安全防护体系의缺失使得模型篡改检测率이 70% 미만으로安全要求较高的应用场景中重大隐患을构成하고 있습니다.
미래를展望하면 엣지 장치에서의 음성 인식 기술 발전은几个重要趋势를呈现할 것입니다.首先는 기술 스택의进一步成熟으로 모델 압축, 하드웨어 가속 및 프레임워크 최적화의协同发展으로 엣지 단 추론 속도를 2-5배提升시키고 에너지 소비를 60-80%降低시킬 것입니다.其次는应用场景의持续扩展으로 스마트 홈에서 산업 자동화,医疗 모니터링에서 교육 훈련에 이르기까지 음성 상호 작용이 인간-기계 상호 작용의 표준方式이 될 것입니다.最后는生態体系의完善으로 소프트웨어와 하드웨어 일체화解决方案이技术门槛을降低시키고 음성 인식 기술의 엣지 장치에서의规模化应用을推动할 것입니다.

 28 Oct, 2025