- By BitSeed
- 音声技術
- 18 Sep
大規模言語モデルがあるのに、なぜまだNLPが必要なのか
GPT-4oは詩を作ることができ、Claudeはプログラミングができ、DeepSeek-R1は推論ができるなど、大規模言語モデルはまるで無所不能のように見えます。しかし、それを実際にスマートスピーカーに組み込んで客室のエアコンを制御させようとすると問題が発生します。671億パラメータのモデルでは、「エアコンをつけて」という4文字を生成するだけでも数秒かかり、その後の機器制御は言うまでもありません。これこそ、大規模言語モデル時代であっても、従来のNLP技術が依然として不可欠な根本的な理由です。
大規模言語モデルとNLPは、本質的に異なる層の問題を解決するものです。大規模言語モデルは複雑な自然言語の生成と理解に長けており、海量のデータで訓練を受けることで強力な言語生成能力を獲得し、多輪対話、創造的ライティング、さらにはコード生成まで行うことができます。しかし、このような汎用能力には代償があります。モデルパラメータはいきなり数十億に達し、推論には大量の計算リソースが必要で、応答遅延は秒単位以上になります。一方、意図分類や実体認識などの従来のNLP技術は、機能は相対的に単一ですが、特定のタスクではミリ秒単位の応答が可能で、正確率は95%を超えます。スマートスピーカーのようなリアルタイム対話シーンでは、ユーザーが「電気を消して」と言った後、3秒待ってから実行されるのでは、ユーザーエクスペリエンスは受け入れがたいものになります。
技術アーキテクチャから見ると、大規模言語モデルはエンドツーエンドのブラックボックス処理方式を採用しており、入力テキストから直接結果を出力し、中間過程は不透明でデバッグが困難です。システムにエラーが発生した場合、意図認識が間違っているのか、実体抽出に問題があるのかを特定するのは難しいです。これに対し、NLPはモジュール化された処理フローを採用しています。まず意図分類を行い、ユーザーが何をしようとしているのかを認識し、次にスロットフィリングを行ってキーパラメータを抽出し、最後に相应するアクションを実行します。このような構造化された処理方式は、問題の特定と最適化を容易にするだけでなく、各モジュールに対して独立した性能調整を行うこともできます。ホテルの客室シーンでは、客人が「温度を20度に調整して」と言った場合、NLPシステムは意図が「温度調整」であり、実体が「20度」であることを正確に認識することができ、全過程が明確かつ制御可能です。
リソース消費の差はさらに顕著です。大規模言語モデルを運行するには通常、ハイエンドのGPUが必要で、消費電力は百ワット級です。これはエッジデバイスにとっては耐えられないものです。最新の量子化技術によりモデルを数GBに圧縮することはできますが、組み込みデバイスでの推論速度は依然としてリアルタイム性の要求を満たすことができません。研究データによると、4ビット量子化された小型LLMでさえ、エッジデバイスでの最初の単語の遅延は500ミリ秒以上になります。一方、専門に最適化されたNLPモデルは数十MBに圧縮することができ、普通のARMチップでもスムーズに動作し、消費電力はわずか数ワットです。このような軽量級の特性により、NLP技術はスマートスピーカー、スマートホームなどのリソース制約のある端末デバイスに大規模にデプロイすることができます。
分野適応性はもう一つの重要な違いです。大規模言語モデルの汎用性は二重刃です。さまざまなトピックを処理することができますが、特定の分野でのパフォーマンスは専門に訓練されたNLPモデルに劣ることがよくあります。たとえば、スマートホーム制御シーンでは、ユーザーの表現方式は相対的に固定されており、主にオン/オフ、調整、クエリなどの限られた意図タイプに関係しています。これらの高頻度シーンに対して訓練されたNLPモデルは、数千件のアノテーションデータで高い正確率を達成することができます。一方、大規模言語モデルに「リビングルームのライトを少し暗くして」のような命令を理解させて正確に実行させるには、複雑なプロンプトエンジニアリングや微調整が必要であり、コストと複雑さが大幅に増加します。
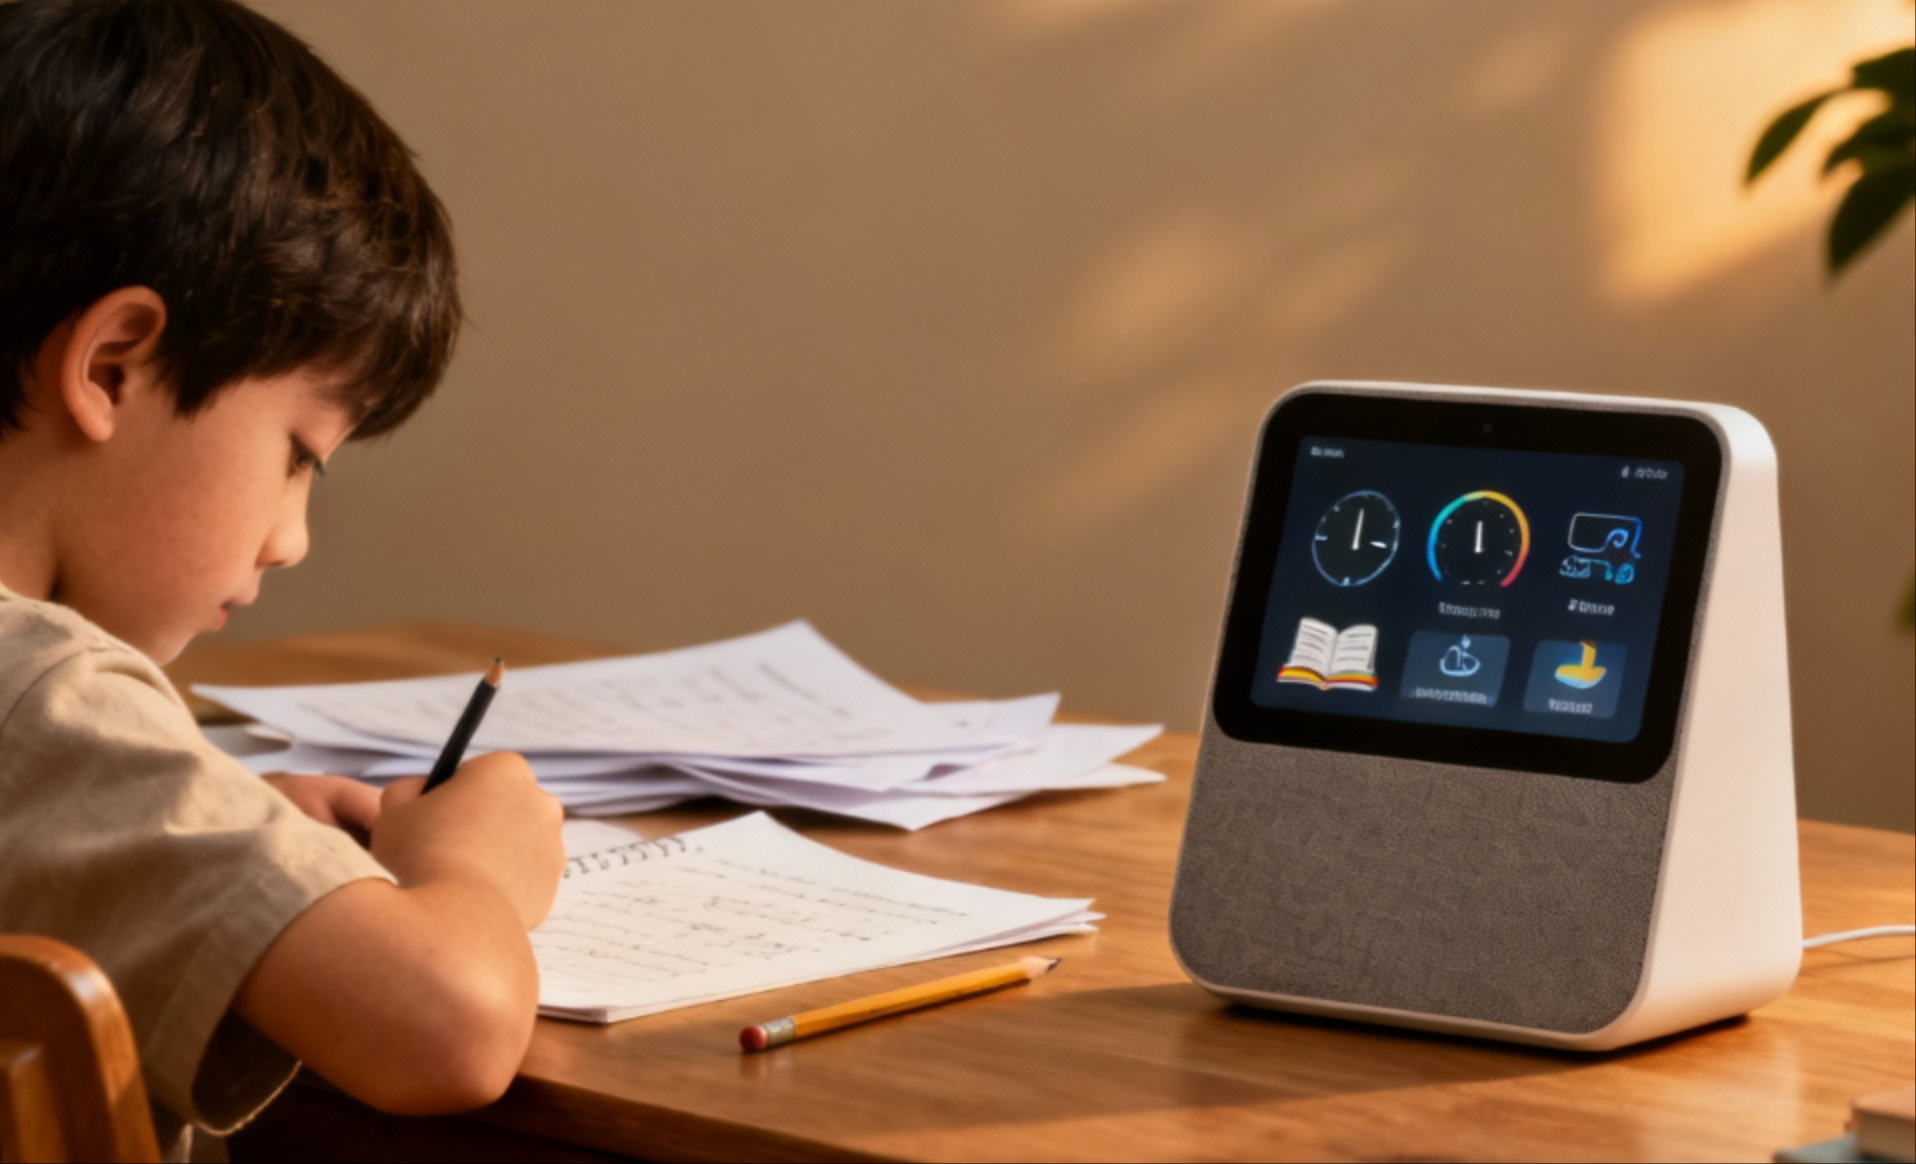
実際のデプロイでは、最適な方案はしばしば大規模言語モデルとNLP技術の協同です。簡単な制御命令や高頻度操作については、軽量級のNLPモデルを端側で直接処理してミリ秒単位の応答を確保し、複雑な自然言語理解、多輪対話、知識クエリなどについては、クラウドの大規模言語モデルサービスを呼び出します。このようなハイブリッドアーキテクチャは、基礎機能のリアルタイム性と信頼性を保証すると同時に、高度なインテリジェント対話体験を提供することができます。たとえば、教育シーンのAI学習端末では、学生が「次の問題」のような簡単な命令はローカルNLPで処理され、「なぜこの問題をこのように解くのか」のような深い問題は大規模言語モデルに回答させます。
プライバシーとセキュリティの考慮もNLP技術の継続的な存在を支持しています。大規模言語モデルは通常、データをクラウドに送信して処理する必要があり、機密情報を処理する場合にプライバシーリスクが存在します。一方、ローカル化されたNLPモデルは完全にオフラインで動作することができ、すべてのデータ処理はデバイス端で完了するため、データ漏洩のリスクはありません。ホテルの客室のようにプライバシーが重視されるシーンでは、ローカルNLPで客人の音声命令を処理する方が明らかに適しています。さらに、NLPモデルの解釈可能性と制御可能性もより強く、企業はシステムの行動境界を正確に制御することができ、大規模言語モデルが発生する可能性のある「幻覚」問題を回避することができます。
コスト効益の対比はさらに明らかです。千万人のユーザーをサポートする大規模言語モデルサービスをデプロイするには、数百万ドルのGPUクラスターと継続的な運営コストが必要です。一方、同等規模のNLPサービスは、普通のCPUサーバーで支えることができ、コストは前者の10分の1になる可能性があります。ほとんどの垂直分野のアプリケーションにとって、大規模言語モデルで「電気をつける」「ドアを閉める」のような簡単な命令を処理するのは、牛刀をもって鶏を殺すようなものであり、リソースを浪費するだけでなく、ユーザーエクスペリエンスにも影響を及ぼします。
AI音声対話端末デバイスプロバイダーとして、私たちは製品設計において大規模言語モデルとNLP技術の長所の補完を十分に考慮しています。端末デバイスに最適化されたNLPエンジンをデプロイすることで、ミリ秒単位の命令応答を提供することができると同時に、クラウドインターフェースを介して大規模言語モデルサービスに接続し、ユーザーに知識クエリ、コンテンツ作成などの高度な機能を提供しています。このような層状のインテリジェントアーキテクチャは、基礎的な対話の流暢性を保証するだけでなく、実際のニーズに応じて高度な能力を柔軟に拡張することができます。大規模言語モデルはAIの新しい時代を開きましたが、落地アプリケーションにおいて、成熟した、効率的で、制御可能なNLP技術は依然として不可欠な基盤です。

 28 Oct, 2025